

Transparence : Abondance utilise l’IA à bon escient.En savoir plus
Abondance utilise l’IA à bon escient.
L’IA nous aide pour la veille et la préparation des articles, et chaque article est relu et validé par l’équipe éditoriale d’Abondance avant sa publication. Notre usage de l’IA.
Un week-end de 403, et des pages qui sortent de Google
Lundi matin, une alerte de la Search Console nous a mis la puce à l'oreille sur le site d'un de nos clients, un e-commerce qui vend des activités de loisirs. Le contrôle d'indexation que nous lançons chaque lundi l'a confirmé : une quarantaine de pages, sur environ 300, n'étaient plus dans l'index de Google, et parmi elles les pages principales du site.
En remontant le fil, la cause est apparue assez vite. Le vendredi soir, l'infogérant du site avait modifié une règle dans Cloudflare, le service placé devant le serveur. Cette règle bloquait les robots de Google, qui recevaient une erreur 403 (« accès interdit ») à chaque visite. Le site s'affichait normalement pour les visiteurs, et le blocage est resté invisible pendant tout le week-end.
À quelques jours du Black Friday, l'une des périodes les plus importantes de l'année pour ce client, le moment était particulièrement mal choisi. Une fois la règle corrigée, nous avons demandé la réindexation des pages dans la Search Console, et elles sont presque toutes revenues dans l'index en moins de 24 heures.
Un simple réglage technique, sur lequel nous n'avions pas de visibilité, a suffi à dégrader l'indexation et le référencement du site.
Pourquoi Google a-t-il réagi aussi vite ?
On imagine souvent qu'une erreur passagère ne pose pas de problème, et que Google attend sagement que le site revienne. Tout dépend en réalité du code d'erreur renvoyé.
Google l'explique dans sa documentation sur les codes HTTP. Une erreur 403 fait partie de la famille des erreurs 4xx, comme la 404. Pour Google, elle signifie que le contenu n'est pas (ou plus) disponible. Une page déjà indexée qui renvoie une 403 est donc retirée de l'index, comme une page supprimée. Google précise même de ne jamais utiliser les codes 401 et 403 pour ralentir ses robots.
Les erreurs serveur (5xx) sont traitées autrement. Google ralentit d'abord son exploration et revient plus tard. Si l'erreur dure, les pages finissent elles aussi par sortir de l'index, simplement moins vite.
Vous l'aurez compris, un week-end de 403 laisse largement le temps à Googlebot de passer sur les pages principales d'un site, puisque ce sont justement celles qu'il visite le plus souvent. À chaque passage, il reçoit le même message : cette page n'existe plus.
Une régression SEO, c'est quoi exactement ?
Une régression SEO, c'est un élément qui fonctionnait et qui se casse sans que personne ne l'ait décidé. Une mise à jour d'extension, une migration de serveur, un réglage de sécurité, une modification de gabarit... Le changement est fait pour une bonne raison, et son effet sur le référencement n'avait simplement pas été anticipé.
Le terme vient du développement logiciel, où l'on parle de « tests de non-régression » pour vérifier qu'une nouvelle version ne casse rien de ce qui marchait avant. Aux États-Unis, le sujet est installé depuis plusieurs années sous les noms de « SEO regression » ou de « SEO QA ». En France, on en parle encore très peu, alors que tous les SEO en ont vécu au moins une.
Une régression se distingue d'une mise à jour de Google. Quand le trafic baisse après une Core Update, la cause est chez Google. Avec une régression, la cause est chez vous, et vous avez la main pour la corriger.
C'est aussi pour cette raison que je considère qu'éviter une régression est parfois plus précieux que de mettre en ligne cinq nouvelles optimisations. Une optimisation fait gagner quelques positions, petit à petit. Une régression peut faire perdre en un week-end ce que des mois de travail avaient construit.
Pourquoi on les découvre toujours trop tard
Une régression se voit rarement le jour où elle arrive, pour plusieurs raisons.
L'effet est d'abord retardé. Si une page passe en noindex aujourd'hui, Google doit repasser dessus avant de la retirer, et la baisse de trafic peut n'apparaître que deux ou trois semaines plus tard. À ce moment-là, plus personne ne se souvient de ce qui a changé.
Le cache masque aussi la panne. Votre page d'accueil s'affiche bien chez vous parce qu'elle sort d'une copie gardée en mémoire, alors que les pages demandées pour la première fois tombent en erreur.
Un blocage en amont, par un pare-feu ou par Cloudflare, ne laisse enfin aucune trace dans les logs du serveur, puisque la visite du robot n'arrive jamais jusqu'à lui.
Les mises en production passent aussi rarement par le SEO. Une mise à jour d'extension ou un réglage chez l'hébergeur sont des opérations courantes, et leurs conséquences sur le référencement ne sont pas toujours faciles à prévoir.
Cinq régressions vécues chez Abondance, en vidéo
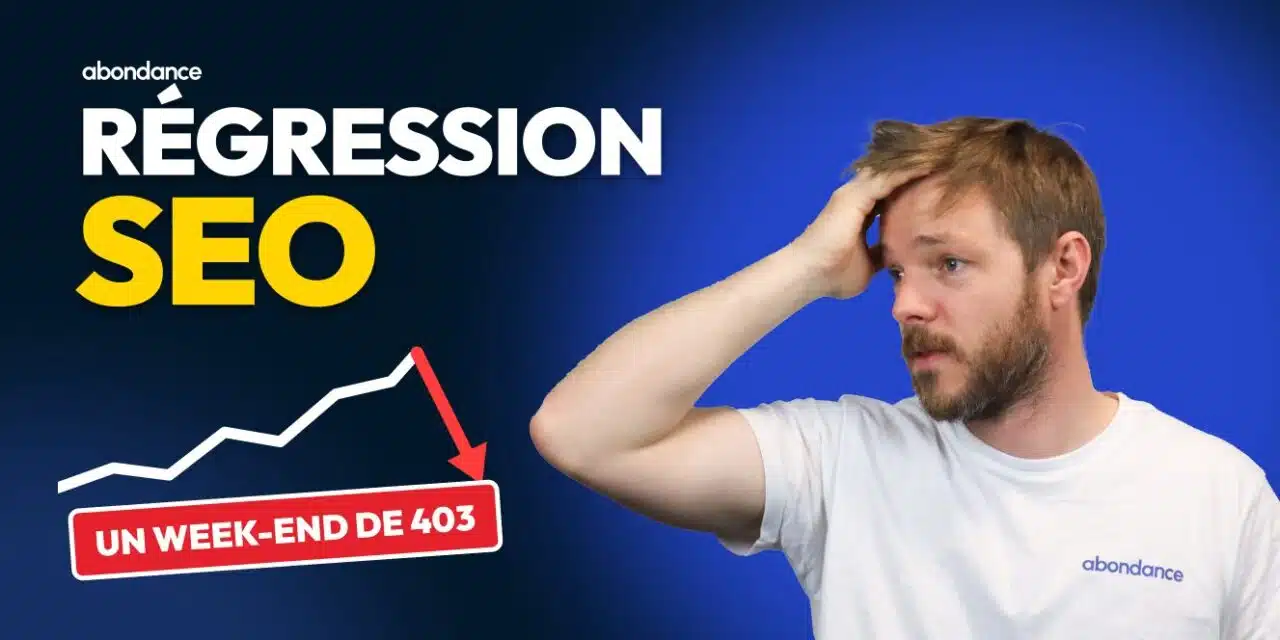
Je vais être transparent avec vous : les cordonniers sont souvent les plus mal chaussés. Ces dernières semaines, nous avons vécu plusieurs régressions sur nos propres sites, et je les raconte dans cette vidéo.
La vidéo est sponsorisée par RocketLinks.
Vous y verrez notamment :
- un robots.txt modifié par Cloudflare chez un client, avec une trentaine de robots d'IA bloqués sans que personne ne l'ait décidé (02:13) ;
- GPTBot, le robot d'OpenAI, absent de nos logs pendant 71 jours à cause d'une règle de pare-feu, alors que notre robots.txt l'autorisait (03:24) ;
- 740 pages avec deux H1 après une mise à jour du thème WordPress d'abondance.com, qui a effacé des modifications faites dans le thème parent (04:28) ;
- des erreurs 500 masquées par le cache après le passage de formaseo.fr en PHP 8.4 (05:46) ;
- une page de reacteur.com en erreur 500 pendant 8 jours, découverte par des auteurs qui n'arrivaient plus à se connecter (06:45).
Aurélien Bardon, le fondateur d'Oseox, a raconté récemment sur LinkedIn deux incidents qui montrent bien jusqu'où une régression peut aller. Dans le premier, chez une grande marque de prêt-à-porter féminin, un membre de l'équipe UX a passé les libellés des filtres d'une catégorie du singulier au pluriel. Une modification anodine en apparence, sauf qu'elle a changé toutes les URL des facettes. Des pages qui se positionnaient dans le top 10 de Google, souvent en première position, se sont retrouvées en 404, pour une perte estimée à 25 000 euros. Dans le second, l'hébergeur d'une marque de prêt-à-porter masculin a envoyé un en-tête « X-Robots-Tag: noindex » sur toutes les URL du site. Cette consigne est invisible dans le code source des pages, et l'affaire a fini devant les tribunaux.
Comment se protéger des régressions SEO ?
Inutile de tout surveiller. Commencez par ce qui ferait le plus de dégâts : le robots.txt, le sitemap, le fichier .htaccess si vous êtes sous Apache, une page par type de gabarit (fiche produit, catégorie, article...) et la vingtaine de pages qui font l'essentiel de votre chiffre d'affaires.
Avant chaque mise en ligne
Le moyen le plus efficace reste de bloquer la régression avant qu'elle parte en production. Ajoutez une courte liste de contrôle SEO à la recette : le robots.txt, la balise meta robots, l'en-tête X-Robots-Tag, les canonicals et les titles des pages clés. Si vous avez une équipe technique, demandez-lui un test automatique qui empêche la mise en ligne quand l'un de ces éléments change.
Tenez aussi un journal des changements, avec la date, l'auteur et la nature de chaque modification (mise à jour d'extension, réglage Cloudflare, migration...). Le jour où le trafic baisse, vous saurez à quoi la rattacher.
Enfin, mettez le SEO dans la boucle. Demandez à votre infogérant, à votre hébergeur et à vos développeurs de vous prévenir avant toute intervention sur Cloudflare, le pare-feu ou le serveur. Si vous le pouvez, inscrivez-le dans le contrat !
Les outils gratuits, à activer dès aujourd'hui
La Search Console (et son équivalent chez Bing, Bing Webmaster Tools) vous envoie des e-mails quand elle détecte un problème. Vérifiez qu'ils arrivent bien dans une boîte que quelqu'un lit. Prenez aussi l'habitude d'ouvrir une fois par semaine le rapport « Statistiques d'exploration » : une hausse des erreurs 403 ou 5xx doit vous alerter tout de suite.
Une sonde de disponibilité, du type UptimeRobot ou Better Stack, interroge votre site toutes les quelques minutes et vous écrit dès qu'il ne répond plus. Les offres gratuites suffisent largement pour surveiller vos pages principales, et l'installation prend quelques minutes.
Un crawl programmé avec Screaming Frog, lancé chaque semaine et comparé au précédent, fait ressortir ce qui a bougé : pages en erreur, titles modifiés, balises noindex, canonicals... C'est d'ailleurs un crawl qui nous a permis de repérer nos 740 pages à deux H1.
Les outils conçus pour la non-régression
Le gratuit a une limite : il vous prévient souvent tard. Des outils ont été créés précisément pour surveiller les régressions, en passant sur vos pages comme le ferait Googlebot et en vous alertant dès qu'un élément change.
Oseox est l'un des pionniers en France (voir aussi sa fiche dans notre annuaire d'outils). Aurélien Bardon explique que ses deux incidents l'ont poussé à développer dès 2015 des tests de non-régression SEO automatisés, qui surveillent toutes les heures les URL critiques d'un site. Il raconte qu'à l'époque, des confrères lui demandaient sur les salons si son outil leur disait quoi faire. Sa réponse rejoint complètement ce que je pense : « détecter un problème avant qu'il ne fasse des dégâts est parfois bien plus rentable que chercher à gagner quelques positions ».
Time Machine, développé par Florian Bessonnat chez Simplex, capture vos pages toutes les heures et relève une trentaine de signaux SEO (title, H1, canonical, meta robots, code de réponse, robots.txt...). Nous l'utilisons sur nos sites. L'outil avait bien vu nos 8 jours d'erreur 500 sur reacteur.com... sauf que nous n'avions paramétré aucune alerte ! Depuis, ses Smart alerts nous préviennent par e-mail dès qu'une page suivie tombe en erreur ou que sa structure change.
Le choix entre ces outils dépend surtout de la taille de votre site et du nombre de pages à suivre. L'important est d'en avoir un, et de vérifier que ses alertes arrivent chez la bonne personne.
Que faire si la régression est déjà là ?
Pas de panique, la plupart des régressions se rattrapent. Voici l'ordre dans lequel je procède.
- Corrigez la cause avant toute autre action : désactivez la règle, restaurez le fichier, revenez à la version précédente.
- Vérifiez ce que reçoit Googlebot : votre navigateur peut afficher la page normalement alors que le robot est toujours bloqué. L'outil d'inspection d'URL de la Search Console, avec son test en direct, vous montre la page telle que Googlebot la reçoit.
- Demandez l'indexation des pages les plus importantes depuis ce même outil, en commençant par celles qui font votre chiffre d'affaires.
- Renvoyez votre sitemap dans la Search Console pour inviter Google à repasser sur l'ensemble du site.
- Suivez la reprise jour après jour dans les rapports d'indexation et de performance, et notez l'incident dans votre journal des changements.
Pour le site de notre client, ces étapes ont suffi : la quasi-totalité des 40 pages étaient de retour dans l'index moins de 24 heures après la demande d'indexation. Ce retour rapide tient sans doute à la courte durée du blocage, repéré dès le lundi. Une régression qui dure plusieurs semaines demande en général plus de patience.
Par où commencer ?
Cette semaine, ouvrez votre robots.txt directement en ligne (Cloudflare peut le modifier sans toucher au fichier de votre serveur), jetez un œil à vos réglages Cloudflare si vous l'utilisez, et vérifiez que les alertes de la Search Console arrivent bien quelque part. Ajoutez ensuite une sonde de disponibilité et une alerte sur vos pages les plus importantes.
Comme le dit Florian Bessonnat, ce n'est jamais au patron ou au client de faire remonter un bug ! De votre côté, quelle est la pire régression SEO que vous ayez vécue ? Racontez-la-nous en commentaire de la vidéo !