

Transparence : Abondance utilise l’IA à bon escient.En savoir plus
Abondance utilise l’IA à bon escient.
L’IA nous aide pour la veille et la préparation des articles, et chaque article est relu et validé par l’équipe éditoriale d’Abondance avant sa publication. Notre usage de l’IA.
Ce qu'il faut retenir :
- La demande de brevet US20260236548A1, publiée le 13 août 2026 par Microsoft Technology Licensing, décrit un système qui compresse les données issues des résultats de recherche pour les faire tenir dans la limite de tokens d'un modèle génératif.
- Pour résumer une page, le système retient les phrases les plus connectées au reste du texte et à la requête, via un graphe de similarité, et favorise celles placées en introduction ou en conclusion.
- Les contenus sont aussi filtrés selon leur fraîcheur, avec des seuils variables selon le domaine, et selon un score de réputation combinant historique d'exactitude, autorité du domaine et validation par les pairs.
- Pour les rédacteurs, le brevet plaide pour des phrases de synthèse autonomes, des contenus datés et des informations recoupables, sans prouver pour autant que Bing ou Copilot appliquent ce système tel quel.
Microsoft décrit la compression des sources avant l’appel au modèle
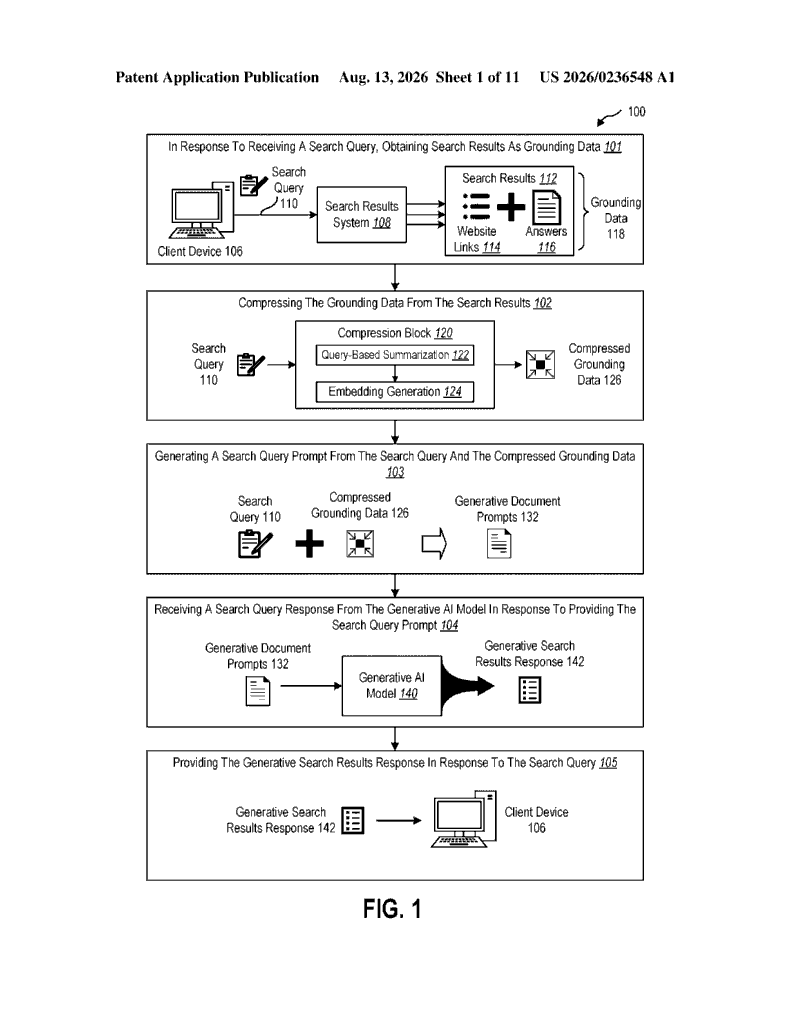
Le document s’intitule « Generating and utilizing compressed grounding data for search engines that utilize generative artificial intelligence models ». Il a été publié le 13 août 2026 sous le numéro US20260236548A1, au nom de Microsoft Technology Licensing LLC, et revendique la priorité d’une demande provisoire indienne déposée le 13 février 2025.
Pour rappel, les « grounding data » (données d’ancrage) sont les contenus récupérés dans les résultats de recherche (liens, extraits, métadonnées, réponses directes) que l’on fournit à un modèle de langage pour qu’il fonde sa réponse sur des faits vérifiables. C’est le principe du RAG (retrieval-augmented generation, ou génération augmentée par la récupération).
Le brevet part d’un constat technique. Quand ces données dépassent la limite de tokens du modèle, il faut multiplier les appels, ce qui coûte du temps et des ressources. Et quand on lui en donne trop d’un coup, le modèle produit des réponses généralistes ou incohérentes. Le texte cite deux défauts connus des LLM :
- Lost in the middle : les informations situées au milieu d’un long prompt sont mal prises en compte.
- Biais de récence : le modèle accorde trop de poids aux éléments placés en fin de prompt.
La solution proposée consiste à « compresser » les données d’ancrage avant de les envoyer, de façon à tout faire passer en un seul appel. Deux techniques sont décrites : un résumé centré sur la requête, puis éventuellement une conversion en embeddings (représentations vectorielles du sens d’un texte). Avant cela, le système peut évaluer la fraîcheur et la crédibilité des contenus.
Dans sa publication LinkedIn, Ian Sorin présente ce brevet comme une description du fonctionnement des chatbots de Microsoft, Copilot et Bing. Le texte de la description parle, lui, de « moteurs de recherche génératifs » en général, et cite comme exemples de modèles GPT-3.5, GPT-4 ou GPT-4o, sans nommer Bing ni Copilot.
Les phrases centrales d’un document sont retenues en priorité
La partie la plus concrète pour les rédacteurs concerne le résumé des pages. Le système commence par nettoyer le contenu : suppression des balises HTML, des caractères spéciaux et des erreurs d’encodage. Ian Sorin en tire une conclusion sur les versions Markdown des pages, qu’il juge inutiles puisque les ingénieurs savent traiter le HTML depuis longtemps. Il s’agit de son analyse : le brevet se contente de mentionner ce nettoyage, sans se prononcer sur le format d’entrée idéal.
Le texte est ensuite découpé en phrases, puis résumé de façon extractive, c’est-à-dire en sélectionnant des phrases existantes plutôt qu’en réécrivant le contenu.
Un graphe de similarité entre les phrases
La première méthode décrite représente chaque phrase comme un nœud d’un graphe. Les liens entre phrases sont pondérés par leur similarité cosinus (une mesure de proximité sémantique). L’importance de chaque phrase est calculée par centralité de vecteur propre. Une phrase est jugée importante si elle est fortement reliée à d’autres phrases elles-mêmes importantes. Le brevet précise que les phrases proches de nombreuses autres phrases, mais aussi de la requête, sont retenues dans le résumé.
C’est ce qu’Ian Sorin appelle un « pagerank des phrases ». L’analogie a du sens : le principe est proche d’algorithmes de résumé automatique connus comme TextRank ou LexRank (ce rapprochement relève de notre analyse, le brevet ne les cite pas). Concrètement, une phrase de synthèse qui reprend plusieurs arguments développés ailleurs dans l’article se retrouve reliée à chacun d’eux, et gagne en centralité. Une nuance toutefois : les liens sont pondérés par le degré de similarité, il ne s’agit donc pas d’un simple comptage.
Les mots-clés ne disparaissent pas du processus
Le brevet décrit deux autres méthodes de sélection :
- Le regroupement (clustering) : les phrases sont classées par thème selon leur proximité sémantique avec la requête, puis une phrase représentative est extraite de chaque groupe, pour couvrir les différents aspects du sujet.
- L’approche fréquentielle : le système privilégie les phrases contenant des termes fréquents ou pertinents par rapport à la requête.
Ce second point semble nuancer quelque peu l’affirmation selon laquelle l’algorithme se moquerait des mots-clés. Le brevet ne l’exclut pas, et indique aussi que la récupération initiale des résultats s’appuie sur les mots-clés extraits de la requête. Le système complète simplement cette approche par une analyse sémantique.
Une dernière méthode, dite fondée sur le discours, analyse la structure rhétorique du texte pour repérer les phrases qui portent le message principal et les arguments qui le soutiennent. C’est sans doute à cette partie que renvoie Ian Sorin quand il évoque la priorité donnée à l’argument principal et à ses appuis, comme les chiffres.
Introductions et conclusions pèsent plus lourd
Une fois les phrases sélectionnées, le résumé est affiné. Le système applique une pondération positionnelle. Pour le dire simplement, les phrases situées dans des positions clés, comme les introductions ou les conclusions, sont favorisées parce qu’elles ont plus de chances de contenir les informations essentielles. Il supprime ensuite les redondances et vérifie que le résumé reste lisible, varié et lié à la requête.
Les contenus anciens sont déclassés, sauf les connaissances durables
L’évaluation de la fraîcheur repose sur l’horodatage de chaque contenu : date de création ou date de dernière modification. Les éléments sont classés du plus ancien au plus récent, et les plus anciens reçoivent une pertinence plus faible.
Ian Sorin indique que ces dates sont extraites des en-têtes serveur, des métadonnées HTML, de l’index de recherche ou du texte lui-même. Précisons que ce détail ne semble toutefois pas être présent dans la description du brevet.
Plusieurs garde-fous sont prévus :
- Exemption des connaissances de fond : les contenus à valeur durable, comme les références historiques ou les savoirs fondamentaux, peuvent échapper au déclassement lié à l’âge.
- Expiration dynamique : les contenus dépassant un seuil d’ancienneté, ou classés au-delà d’un certain rang (le brevet donne l’exemple des 1 000 premiers éléments), sont retirés.
- Seuils par domaine : un article d’actualité chaude a une durée de vie plus courte qu’une publication académique ou un manuel technique.
- Détection des mises à jour : le système surveille les modifications d’articles ou de jeux de données pour utiliser la version la plus récente.
Autrement dit, la mise à jour d’un contenu n’est pas seulement un signal pour les moteurs classiques. Dans ce système, elle conditionne directement la place du contenu dans les données transmises au modèle.
Réputation, neutralité et corroboration filtrent les sources
L’évaluation de la crédibilité commence par un score de réputation, qui agrège trois critères en une métrique pondérée :
- L’exactitude historique,
- L’autorité du domaine
- La validation par les pairs.
Le brevet ne précise pas comment ces critères sont mesurés, ce que relève aussi Ian Sorin à propos de la validation par les pairs. À noter : le texte parle de la fiabilité des sources et des données, sans mentionner explicitement les auteurs.
Le système croise ensuite les informations entre plusieurs sources indépendantes, pour limiter le risque d’erreur ou de biais. Il utilise aussi des modèles de détection des biais, qui analysent les schémas linguistiques et le cadrage des contenus pour repérer ceux qui sont subjectifs ou orientés, puis prend des mesures correctives pour que la réponse finale reste neutre.
Dernier critère, la diversité des sources. Le système cherche à éviter de dépendre d’une seule perspective. Il repère les informations soutenues par un nombre de sources inférieur à un seuil défini, et tente alors de trouver des sources complémentaires. Le texte ne dit pas explicitement que ces informations sont pénalisées si aucune source supplémentaire n’est trouvée.
Si le volume reste trop important après ces étapes, le brevet prévoit de retirer les données les moins pertinentes, les moins fraîches ou les moins crédibles jusqu’à passer sous la limite de tokens, éventuellement en alternant entre ces critères. Il mentionne aussi la possibilité de réutiliser une version déjà compressée, stockée pour une requête similaire.
Un brevet qui donne des pistes, et non recette appliquée par Bing
Comme toujours avec les brevets, la prudence s’impose. Le texte décrit de nombreuses variantes introduites par « dans certaines implémentations », et sa publication ne prouve pas que ce système tourne aujourd’hui derrière Bing ou Copilot. Il éclaire en revanche la logique de sélection qu’un moteur génératif peut appliquer aux pages qu’il récupère.
Plusieurs enseignements pratiques en découlent pour les équipes contenu :
- Phrases de synthèse : une phrase autonome qui résume les arguments développés dans l’article a plus de chances d’être jugée centrale et retenue.
- Placement : l’essentiel de l’information gagne à figurer en introduction et en conclusion de section.
- Datation : des dates de publication et de mise à jour visibles et à jour pèsent sur l’évaluation de fraîcheur, surtout sur les sujets d’actualité.
- Ton : un style factuel et sans emphase limite le risque d’être signalé comme contenu orienté.
- Recoupement : les données chiffrées et affirmations vérifiables ailleurs ont plus de poids que les informations isolées.
Ce dernier point soulève une question que le brevet laisse ouverte : le sort des informations exclusives. Un scoop ou une donnée propriétaire, par définition reprise par peu de sources au moment de sa publication, déclenche la recherche de sources complémentaires. Le texte ne précise pas ce qu’il advient de cette information lorsque le système n’en trouve aucune.