

Ce qu'il faut retenir :
- Les modèles de langage classiques, utilisés pour décomposer une requête large en sous-requêtes, tombent souvent dans le piège de la reformulation : ils produisent des variantes proches du même terme au lieu de couvrir des angles différents.
- Retrieve-for-Train sépare l'apprentissage de l'exécution : un entraînement par renforcement, mené une seule fois hors ligne, sert à produire les données qui entraînent ensuite un modèle de diffusion léger, rapide à l'usage.
- Le modèle final ne compte que 53,9 millions de paramètres et affiche un gain de vitesse compris entre 12 et 20 fois par rapport aux approches autorégressives classiques.
- Un système de récompense à trois critères (ancrage dans la base de données, diversité, fidélité à la requête initiale) empêche le modèle de tricher en générant des résultats absurdes ou redondants.
Des résultats de recherche qui se ressemblent tous
Quand un utilisateur tape une requête large comme « matériel de camping », il n'attend pas dix variantes du même modèle de tente. Au contraire, il attend un ensemble cohérent et complémentaire : une tente, un sac de couchage, un réchaud portable, une lampe frontale. Pour produire ce type de résultat, les systèmes de recherche utilisent une technique appelée query fan-out, qui consiste à décomposer une requête générale en plusieurs sous-requêtes censées couvrir les différents besoins de l'utilisateur.
Le souci, c'est que confier cette décomposition à un modèle de langage classique pose deux problèmes de fond.
Le premier est ce que les chercheurs appellent le collapse paraphrastique. Sans optimisation spécifique à la base de données ciblée, un modèle de langage a tendance à générer des requêtes redondantes, presque synonymes les unes des autres. Pour une requête comme « style festival bohème », un modèle standard peut se contenter de produire « mode festival bohème » et « vêtements festival bohème », deux formulations qui reviennent au même. Un expert du secteur, lui, explorerait des directions distinctes : veste à franges, robe en crochet, bottes en daim.
Le second problème est la latence liée au fonctionnement autorégressif des modèles de langage. Pour décomposer correctement une requête complexe, ces modèles doivent générer des centaines de jetons de raisonnement intermédiaire avant de produire les termes de recherche eux-mêmes. Ce fonctionnement séquentiel, acceptable pour une conversation, devient un frein sérieux dès qu'il faut produire un grand nombre de sous-requêtes simultanément. Même avec des optimisations serveur avancées, cette architecture token par token crée un plancher de latence incompatible avec les temps de réponse attendus d'une barre de recherche en production.
Le principe de Retrieve-for-Train : entraîner une fois, exécuter instantanément
L'idée centrale du framework consiste à traiter l'entraînement comme une session de préparation hors ligne plutôt que comme un examen à passer en direct pendant que l'utilisateur attend. Au lieu de faire réfléchir le modèle à chaque requête, Retrieve-for-Train lance un programme d'apprentissage par renforcement une seule fois, en amont.
Ce programme s'appuie sur un système de récompense rigoureux qui transforme des objectifs abstraits, comme « des résultats divers et disponibles en stock », en instructions précises et reproductibles. Une fois ce travail effectué, le modèle final peut exécuter ces instructions instantanément lors d'une recherche réelle.
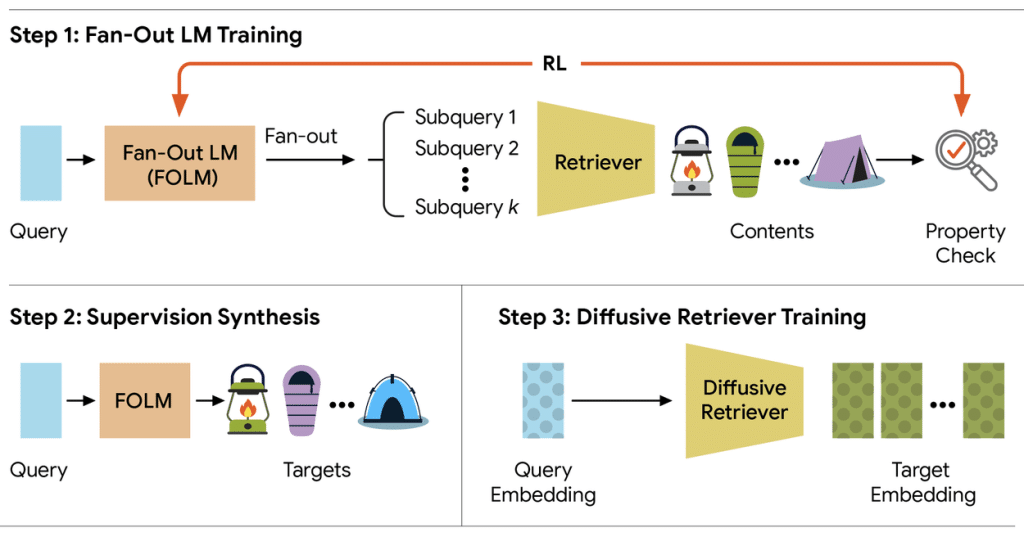
Le pipeline se décompose en trois étapes :
- Entraînement du modèle de fan-out : un modèle de langage est entraîné par renforcement pour produire des sous-requêtes alignées avec les propriétés recherchées, évaluées par une récompense qui juge l'ensemble des résultats plutôt que chaque résultat pris isolément.
- Synthèse des données de supervision : une fois figé, ce modèle de fan-out génère automatiquement des paires requête / ensemble cible, entièrement hors ligne et sans intervention humaine.
- Entraînement du modèle de diffusion : un modèle compact de 53,9 millions de paramètres apprend à faire correspondre directement l'embedding d'une requête à un ensemble complet d'embeddings cibles, en un seul passage non séquentiel. Cette étape permet de se passer entièrement des jetons de raisonnement textuel.
Un système de récompense construit autour de trois piliers
La qualité du dispositif repose entièrement sur la façon dont le « bon » comportement de recherche est défini. L'apprentissage supervisé traditionnel évalue la pertinence de chaque résultat pris séparément. Or un ensemble de résultats vraiment pertinent se définit par des propriétés collectives : diversité, couverture, complémentarité. Ces propriétés n'existent que si l'on évalue l'ensemble dans sa globalité, pas un élément à la fois.
Pour éviter de s'appuyer sur des instructions en langage naturel trop vagues, les chercheurs ont affiné deux modèles open source de 4 milliards de paramètres, Gemma3-4B et Qwen3-4B, à l'aide d'une récompense mathématique composite reposant sur trois critères :
- L'ancrage (groundedness), qui pénalise l'éloignement par rapport à la base de données réelle, pour s'assurer que chaque sous-requête générée correspond à un élément effectivement disponible.
- La diversité, mesurée via le Vendi Score sur l'ensemble des sous-requêtes, qui pousse le modèle à explorer une large étendue sémantique.
- L'alignement, qui rattache les sous-requêtes générées à la requête d'origine pour éviter toute dérive de sens.
Ces trois critères jouent le rôle de contre-poids les uns par rapport aux autres. Un modèle optimisé uniquement pour l'ancrage finira par générer des chaînes de caractères dénuées de sens mais qui, mathématiquement, correspondent à une coordonnée précise de la base de données. Si l'on ajoute l'alignement pour corriger ce défaut, le modèle contourne le problème en se contentant de reformuler la requête initiale de façon répétitive. C'est l'ajout du Vendi Score comme contre-ancrage qui empêche ces raccourcis : pour obtenir une récompense élevée, le modèle est contraint de trouver un équilibre entre des variantes strictement ancrées dans la base et sémantiquement distinctes.
L'entraînement du modèle de fan-out repose sur une méthode appelée group relative policy optimization (GRPO), combinée à une régularisation de type PPO en version « soft ».
Les résultats des expérimentations
Pour évaluer le framework, les chercheurs ont travaillé sur deux types de tâches de recherche par ensembles :
- La recherche abstraite ouverte, où aucune vérité de référence unique n'existe et où la qualité se mesure uniquement à travers des propriétés d'ensemble (diversité, alignement, ancrage) ;
- La recherche compositionnelle faiblement supervisée, où les requêtes sont associées à un ensemble de référence qui ne représente qu'une des réalisations plausibles possibles.
Les tests ont porté sur deux domaines multimodaux : un jeu de données de mode à grande échelle, composé de tenues assemblées par des utilisateurs, évalué avec un modèle de type CLIP pour la recherche texte-image ; et un jeu de données industriel propriétaire de playlists musicales créées par des experts, évalué avec MuLan pour la recherche texte-musique. Dans les deux cas, les modèles de fan-out devaient générer exactement dix sous-requêtes par requête initiale.
Sur ces deux tâches, Retrieve-for-Train a surpassé la recherche à requête unique classique, l'expansion sans entraînement spécifique (zero-shot) et même une référence optimisée de type Best-of-N. D'un point de vue qualitatif, les modèles zero-shot ont continué à produire des paraphrases quasi synonymes, comme « style festival bohème » et « mode festival bohème », causant des résultats redondants. Retrieve-for-Train, lui, a généré des sous-requêtes nettement plus diverses (par exemple en explorant des pistes comme « bottes » ou « dentelle ») tout en restant strictement ancré dans la base de données.
Mais le gain le plus marquant concerne la vitesse d'exécution. Déployer directement le modèle de langage entraîné par renforcement donnait de très bons résultats en matière de qualité de recherche, mais héritait des contraintes de latence propres au fonctionnement autorégressif. En distillant ce comportement appris dans le modèle de diffusion de 53,9 millions de paramètres, les chercheurs ont supprimé ce goulot d'étranglement. Comme ce modèle génère toutes les directions cibles simultanément, en un seul passage non séquentiel dans l'espace des embeddings, il obtient un gain de vitesse compris entre 12 et 20 fois par rapport aux approches autorégressives.
À grande échelle, la latence du fan-out autorégressif grimpe de façon linéaire jusqu'à près de 50 secondes avec des lots de contexte importants, tandis que la version diffusion de Retrieve-for-Train reste comprise entre une fraction de seconde et quelques secondes.
En conclusion
En analysant le processus d'optimisation de la récompense, les chercheurs ont observé un phénomène révélateur : sans le terme de diversité, le modèle s'effondre rapidement et se met à générer des chaînes de caractères dénuées de sens (comme des répétitions absurdes) pour exploiter mathématiquement les coordonnées vectorielles de la base de données. L'ajout d'une métrique géométrique de diversité, le Vendi Score, agit comme un garde-fou : il force le modèle à rester dans une zone stable de l'espace des embeddings, où il ne peut maximiser sa récompense qu'en se comportant réellement comme un expert de la recherche.