

Transparence : Abondance utilise l’IA à bon escient.En savoir plus
Abondance utilise l’IA à bon escient.
L’IA nous aide pour la veille et la préparation des articles, et chaque article est relu et validé par l’équipe éditoriale d’Abondance avant sa publication. Notre usage de l’IA.
Ce qu'il faut retenir :
- Selon Peec AI, ChatGPT Shopping s'appuie aux États-Unis sur Labrador, l'index d'OpenAI alimenté par des flux produits, alors qu'en Europe il récupère toujours les résultats de Google Shopping via une API tierce.
- Aux États-Unis, une boutique dépourvue du statut de vendeur vérifié disparaît des résultats : dans un test, un marchand présent sur 25 des 32 produits candidats n'a placé aucun produit dans le carrousel.
- ChatGPT tronque chaque description produit à 50 tokens, soit environ 40 mots en anglais, et ne prend en compte que ce début de texte au moment de noter les produits.
- Peec AI recommande d'envoyer son flux à OpenAI, de placer les informations clés en tête de description, de déclarer chaque variante séparément et de soigner Google Shopping tant que Labrador n'est pas déployé en Europe.
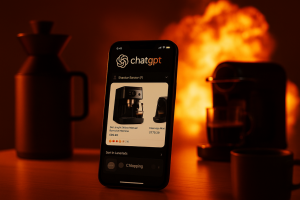
ChatGPT Shopping fonctionne avec deux systèmes distincts selon la région
Le constat vient de Peec AI, éditeur d’outils de suivi de la visibilité dans les IA génératives. Dans un article publié le 16 octobre 2026 sur le blog de l’entreprise, Metehan Yesilyurt indique que l’équipe a eu accès à une API de debug de ChatGPT. Pour chaque prompt, elle renvoie environ 150 000 lignes de données sur la récupération des produits, dont le score attribué à chacun d’eux. Malte Landwehr, CPO et CMO de Peec AI, a présenté ces résultats lors de brightonSEO 2026.
Selon ces données, OpenAI a fait basculer le shopping américain sur son propre système de récupération quelques semaines avant cette conférence. Dans les sessions américaines, un indicateur nommé « Labrador shopping version 2 » est activé, tandis que celui du scraping de Google Shopping via une SERP API (un service tiers qui extrait les pages de résultats d’un moteur) est désactivé. Les sessions européennes présentent la configuration inverse.
Peec AI résume les différences ainsi :
- Source des produits : l’index Labrador, construit à partir de flux produits, aux États-Unis. Google Shopping, scrapé via une SERP API, en Europe.
- Condition d’entrée : envoyer un flux à OpenAI ou vendre via Shopify aux États-Unis. Être référencé dans Google Shopping en Europe.
- Contrôle du vendeur : statut de vendeur vérifié exigé aux États-Unis, aucun contrôle en Europe.
- Notation de la pertinence : embeddings, BM25 et correspondance GTIN aux États-Unis. Aucune en Europe, où les résultats sont répartis à tour de rôle entre les requêtes.
- Temps de récupération : environ 0,6 seconde aux États-Unis contre environ 4 secondes en Europe.
- Suivi des clics : paramètre utm_medium=feed sur les liens produits américains, absent en Europe.
Pour rappel, le carrousel shopping correspond au bloc de fiches produits qui apparaît dans une réponse de ChatGPT, avec un à sept produits, parfois présentés sous forme de tableau. Ces observations n’ont pas été confirmées publiquement par OpenAI : elles proviennent de l’analyse de Peec AI, qui commercialise par ailleurs un outil de suivi de ChatGPT Shopping.
Aux États-Unis, le flux produit conditionne la visibilité
Au moment de la conférence, le shopping américain s’appuyait sur 669 flux, dont 606 actifs. Environ 70 provenaient de partenariats directs, dans lesquels une marque comme Nike transmet elle-même son flux à OpenAI. Près de 500 étaient encore des flux construits par OpenAI en scrapant les sites des marchands via Bright Data. Le reste passait par Shopify, avec un flux issu de Salesforce et un autre d’une intégration Stripe. Lorsqu’une marque signe un partenariat direct, OpenAI désactive le flux qu’il avait construit à partir de son site.
Pour observer la sélection, Peec AI a testé un prompt portant sur des chaussures de running. ChatGPT a récupéré 41 produits candidats, en a transformé 32 en « blocs de prompt » détaillés (titre, description, notes, GTIN, etc.) et en a affiché 5. Le GTIN (Global Trade Item Number) est l’identifiant international d’un article, l’EAN en Europe.
Pour chaque candidat, les données de debug montrent plusieurs signaux de recherche d’information classiques :
- Scores d’embeddings : proximité sémantique entre la requête et le produit, calculée à partir de représentations vectorielles.
- Score BM25 : algorithme de classement lexical fondé sur la fréquence des termes de la requête dans le texte.
- Récupération ANN : recherche approximative des plus proches voisins dans l’espace vectoriel.
- RRF (reciprocal rank fusion) : méthode qui fusionne plusieurs classements en un seul.
Metehan Yesilyurt souligne que BM25 peut être exécuté localement sur ses propres données produits pour se faire une idée de la façon dont une fiche se classe.
Sans statut de vendeur vérifié, une boutique disparaît des résultats
Chaque produit candidat porte un attribut is_site_verified_seller. Sans lui, la boutique est purement et simplement exclue. Dans le test, un marchand détenait 25 des 32 candidats mais n’a placé aucun produit dans les résultats finaux, faute de ce statut. Peec AI reconnaît ne pas avoir encore identifié ce qui détermine son attribution.
Chaque variante peut occuper une place dans le carrousel
Dans le même test, Dick’s Sporting Goods avait cinq produits candidats et quatre se sont retrouvés parmi les cinq résultats. Nike en avait deux, dont un a été retenu. La déduplication a seulement supprimé une même chaussure déclinée en plusieurs tailles.
Peec AI en tire une logique opposée aux habitudes SEO, où l’on vise une page par produit. Dans un système fondé sur les flux, il est préférable d’envoyer chaque article et chaque variante (modèle, couleur) comme une entrée distincte, ce qui multiplie les chances de prendre de la place aux concurrents.
Les descriptions sont coupées à 50 tokens
Chaque description produit intégrée à un bloc de prompt est tronquée à exactement 50 tokens. Dans le test, l’une d’elles s’arrêtait en plein milieu d’une phrase (« Pattern offers a smooth heel to… »). En anglais, 50 tokens correspondent à environ 40 mots ou 250 caractères. Le reste du texte n’est pas pris en compte lors de la notation.
Une précision : ces équivalences concernent l’anglais. Le français étant généralement découpé en un plus grand nombre de tokens, la part de description réellement lue pourrait être un peu plus courte pour une fiche rédigée en français, mais cela reste à mesurer.
Personnalisation, test sans Amazon et petits modèles en coulisses
Les données de debug détaillent aussi les signaux de personnalisation dont dispose le système de shopping :
- Localisation : domicile et position actuelle de l’utilisateur, et le fait qu’il partage ou non sa position précise.
- Genre estimé : une estimation assortie d’un score de confiance.
- Historique : les marchands et places de marché déjà vus ou cliqués.
D’après Peec AI, les résultats deviennent donc de plus en plus personnalisés avec le temps.
Les données listent également les tests A/B menés par OpenAI. L’un d’eux, baptisé « No Amazon », affiche des résultats shopping américains sans aucun produit Amazon. Il ne s’agit que d’un test, mais il montre que la répartition des marchands peut changer rapidement.
Le texte qui entoure le carrousel repose sur une recherche web distincte. Dans le test, celle-ci a remonté 42 sources candidates, et ChatGPT en a utilisé une seule (Runner’s World). Labrador dispose d’index séparés pour le web, Reddit, l’actualité, les PDF, YouTube et Wikipédia. Peec AI précise que puiser dans un index ne signifie pas que ChatGPT le privilégie dans ses citations : il sert souvent de simple contexte pour rédiger la réponse.
Enfin, si la réponse affichée à l’utilisateur est produite par le modèle phare, la récupération, la sélection et la rédaction des blocs produits reposent sur des versions personnalisées de GPT-4o, GPT-4.1 nano et GPT-5 mini, au sein d’une même session.
En Europe, Google Shopping alimente toujours ChatGPT
Le fonctionnement européen est plus simple et plus lent. Pour un prompt de test, ChatGPT a envoyé cinq requêtes de fan-out (les recherches lancées en arrière-plan pour répondre à un prompt) à Google Shopping via une SERP API. Chacune a renvoyé entre 1 et 40 produits.
ChatGPT a ensuite fusionné ces résultats à tour de rôle : le premier produit de chaque requête, puis le deuxième de chaque requête qui en avait encore, et ainsi de suite, jusqu’à obtenir une liste de 113 produits. Sa réponse en a affiché 18. L’ensemble de l’étape a pris environ quatre secondes.
Cette dépendance à Google Shopping a deux conséquences :
- Aucun embedding, aucun BM25 ni aucune correspondance GTIN ne sont appliqués aux résultats.
- Et aucun contrôle de vendeur n’est effectué : toute boutique présente dans Google Shopping est considérée comme fiable par ChatGPT en Europe.
Pour l’instant, la performance dans ChatGPT Shopping en Europe reflète donc directement celle obtenue dans Google Shopping. Selon Peec AI, un bon positionnement actuel dans ChatGPT en Europe pourrait ne pas résister à l’arrivée de Labrador, qu’OpenAI devrait selon eux finir par déployer dans la région.
Ce que Peec AI recommande aux e-commerçants
Metehan Yesilyurt liste six actions :
- Transmettre son flux à OpenAI : directement ou en vendant via Shopify. Les flux scrapés sont une solution transitoire, qu’OpenAI cherche à remplacer par des partenariats.
- Placer l’essentiel dans les 40 premiers mots des descriptions : au-delà de 50 tokens, le texte est ignoré.
- Déclarer chaque variante séparément : chaque couleur ou modèle représente une chance supplémentaire d’apparaître dans le carrousel.
- Passer ses données produits dans BM25 : l’opération est gratuite, se fait en local et donne une indication de la pertinence perçue par l’un des composants clés de la récupération.
- Maintenir une présence solide dans Google Shopping en Europe : elle reste la source des résultats européens tant que Labrador n’y est pas déployé.
- Suivre les clics issus des flux : le paramètre utm_medium=feed permet d’attribuer dans les outils d’analytics le trafic provenant du shopping américain.
Deux inconnues pèsent toutefois sur ces recommandations. Peec AI ne sait pas encore quels critères déclenchent l’attribution du statut de vendeur vérifié, pourtant éliminatoire aux États-Unis. Et aucune date n’a été avancée pour l’arrivée de Labrador en Europe.